Настройка резервного копирования: как проверить восстановление сервиса
100 %
300 ГБ исчезли за секунды: как проверить, что бэкап вернёт сервис вовремя
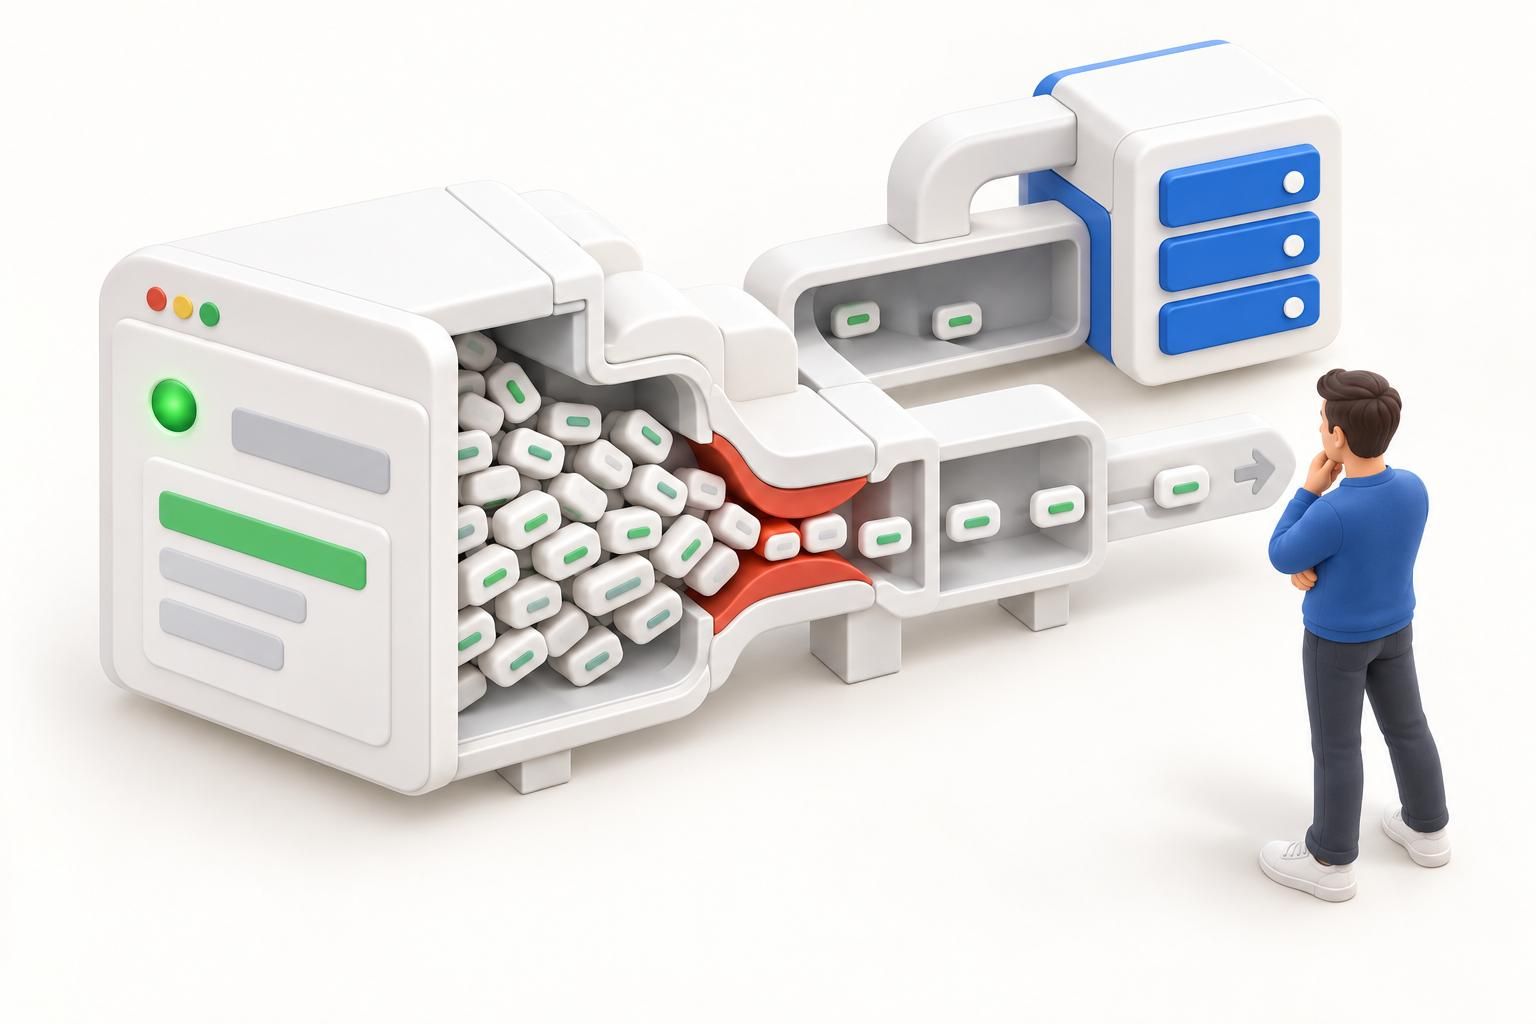
Сотрудник команды GitLab хотел заново настроить резервный сервер PostgreSQL и через несколько секунд остановил команду: она удаляла данные на основной базе. К этому моменту исчезли около 300 ГБ. Затем взяли резервную копию и выяснили, что привычный pg_dump завершался с ошибкой, а уведомления об этом не доходили.
Это случилось с GitLab.com. В публичном разборе инцидента описано, как для восстановления пришлось взять снимок шестичасовой давности. Перенос данных занял около 18 часов. Сервис вернулся, часть проектов, комментариев и учётных записей вернуть не удалось.
В рабочем тесте мы проходим всю цепочку: поднимаем данные в отдельном окружении, запускаем приложение, проверяем критичный сценарий и измеряем время до готовности продукта. На примерах «Стадикэтс» и «Понимаю» покажем, какие вопросы эта проверка ставит перед большим сервисом.
Две цифры связывают бэкап с потерями бизнеса
RPO, Recovery Point Objective, задаёт допустимую потерю данных во времени. RTO, Recovery Time Objective, определяет предельную длительность восстановления. AWS Well-Architected рекомендует подтверждать оба показателя в ходе учений: RPO — по свежести восстановленной точки, RTO — по всему пути до готовности системы к работе.
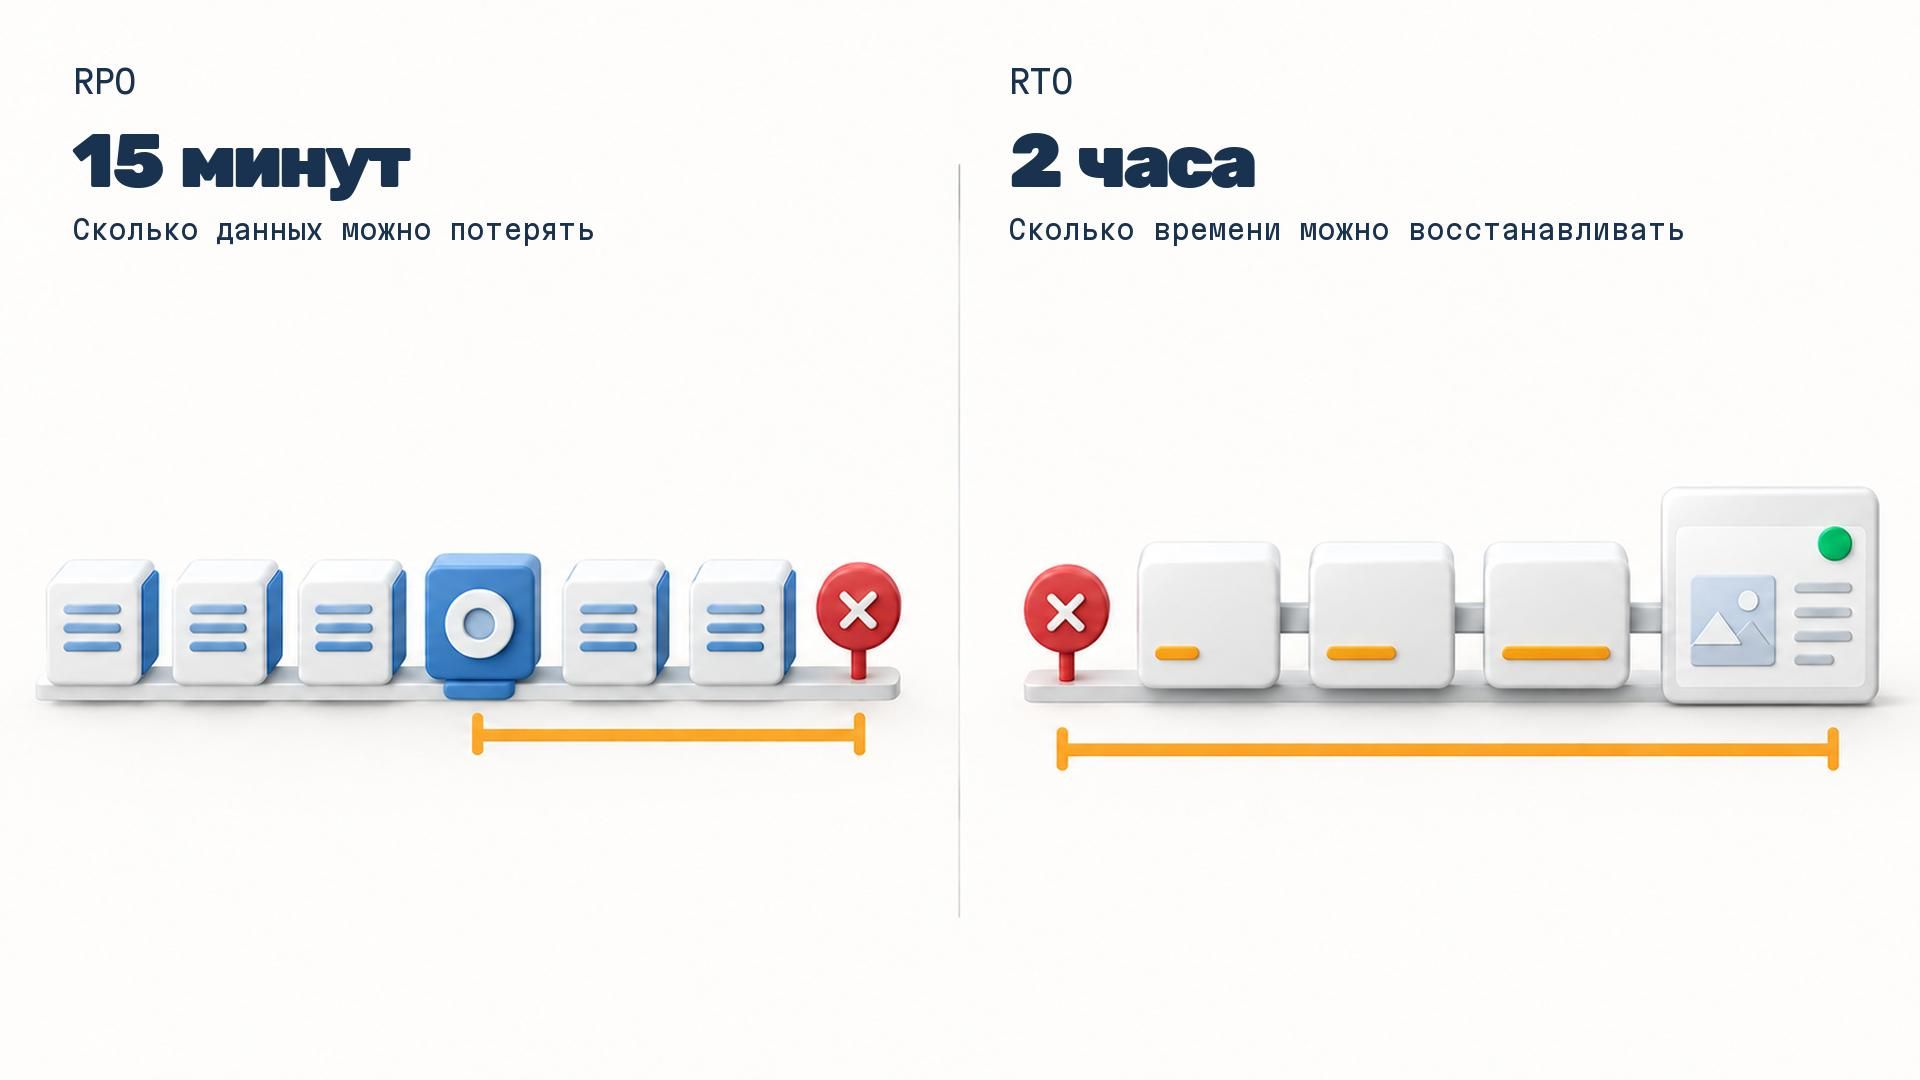
В «Стадикэтс» мы объединили шесть образовательных курсов в одну платформу: с личным кабинетом, домашними заданиями, пробниками и статистикой прогресса. Для такого контура RPO и RTO обсуждают не абстрактно. Нужно решить, за какой интервал допустимо потерять отправленные задания, результаты пробников, покупки и изменения доступа к курсу. Ответ задаёт требования к данным и времени возврата критичных сценариев.
Допустим, интернет-магазин принимает заказы постоянно. RPO в 15 минут означает, что компания допускает потерю изменений максимум за этот интервал. При RTO в два часа критичный сценарий должен вернуться в строй в пределах этого срока. Эти значения служат условиями примера, а не универсальной нормой.
Мы начинаем с процессов: перечисляем критичные действия пользователей, определяем допустимую потерю данных для каждого, фиксируем срок возврата функции и проверяем выбранную стратегию на тесте. Единый RPO для всех наборов данных обычно даёт лишние расходы в одних местах и слишком мягкую защиту в других.
База поднялась, а продукт ещё лежит
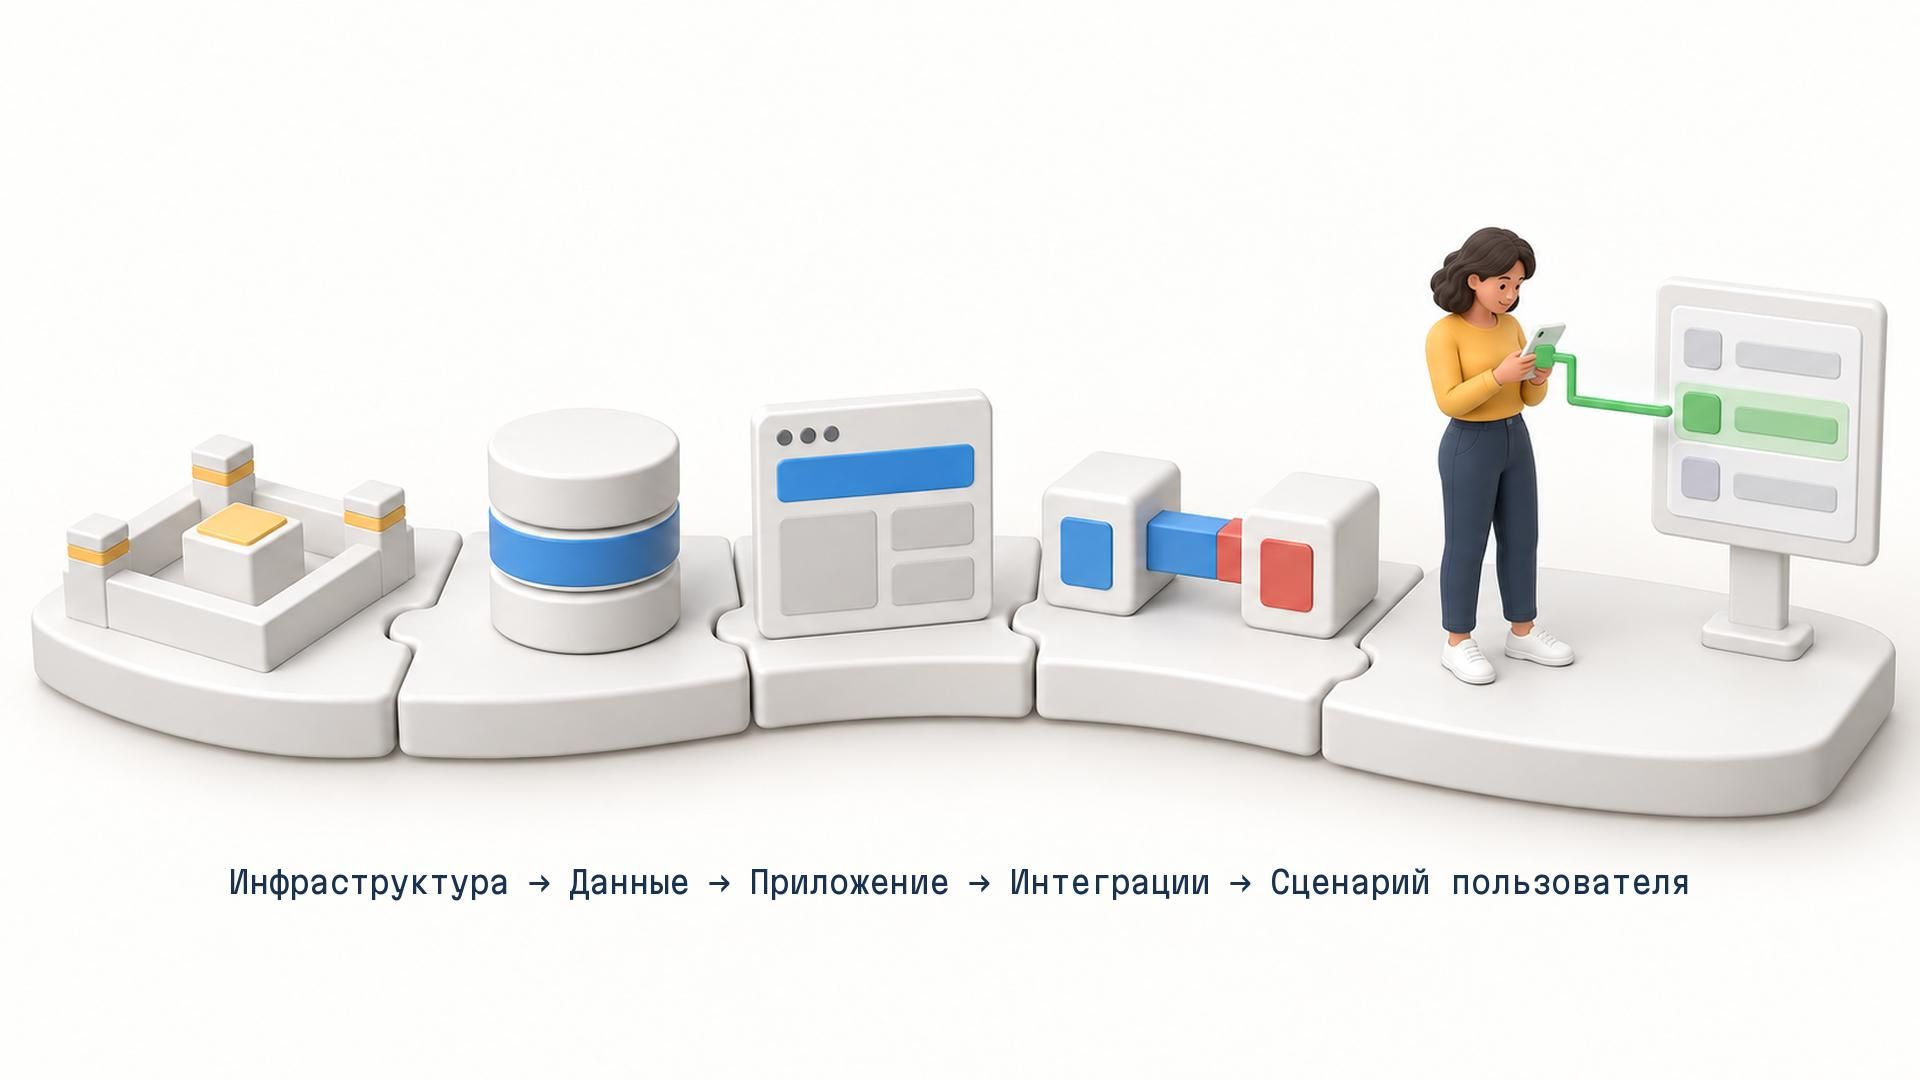
Готовность базы данных часто принимают за конец процедуры. Пользовательский сервис зависит от версии приложения, конфигурации инфраструктуры, объектного хранилища, очередей, поискового индекса, ключей шифрования, DNS, фоновых заданий и внешних интеграций.
«Понимаю» — корпоративная платформа поддержки сотрудников с онлайн-консультациями разных специалистов. В таком сервисе критичным становится не только подъём базы: восстановленный продукт должен вернуть пользователю возможность войти по корпоративному доступу, увидеть запланированную встречу и подключиться к консультации.
На практике мы выстраиваем очередность по зависимостям: сначала поднимаем инфраструктуру и доступ к ключам, затем хранилища данных, после этого приложение, фоновые процессы и интеграции. Последним проверяем сквозной сценарий. Самая медленная обязательная зависимость определяет срок возврата бизнеса.
Зелёный статус задания заканчивается запросом к данным
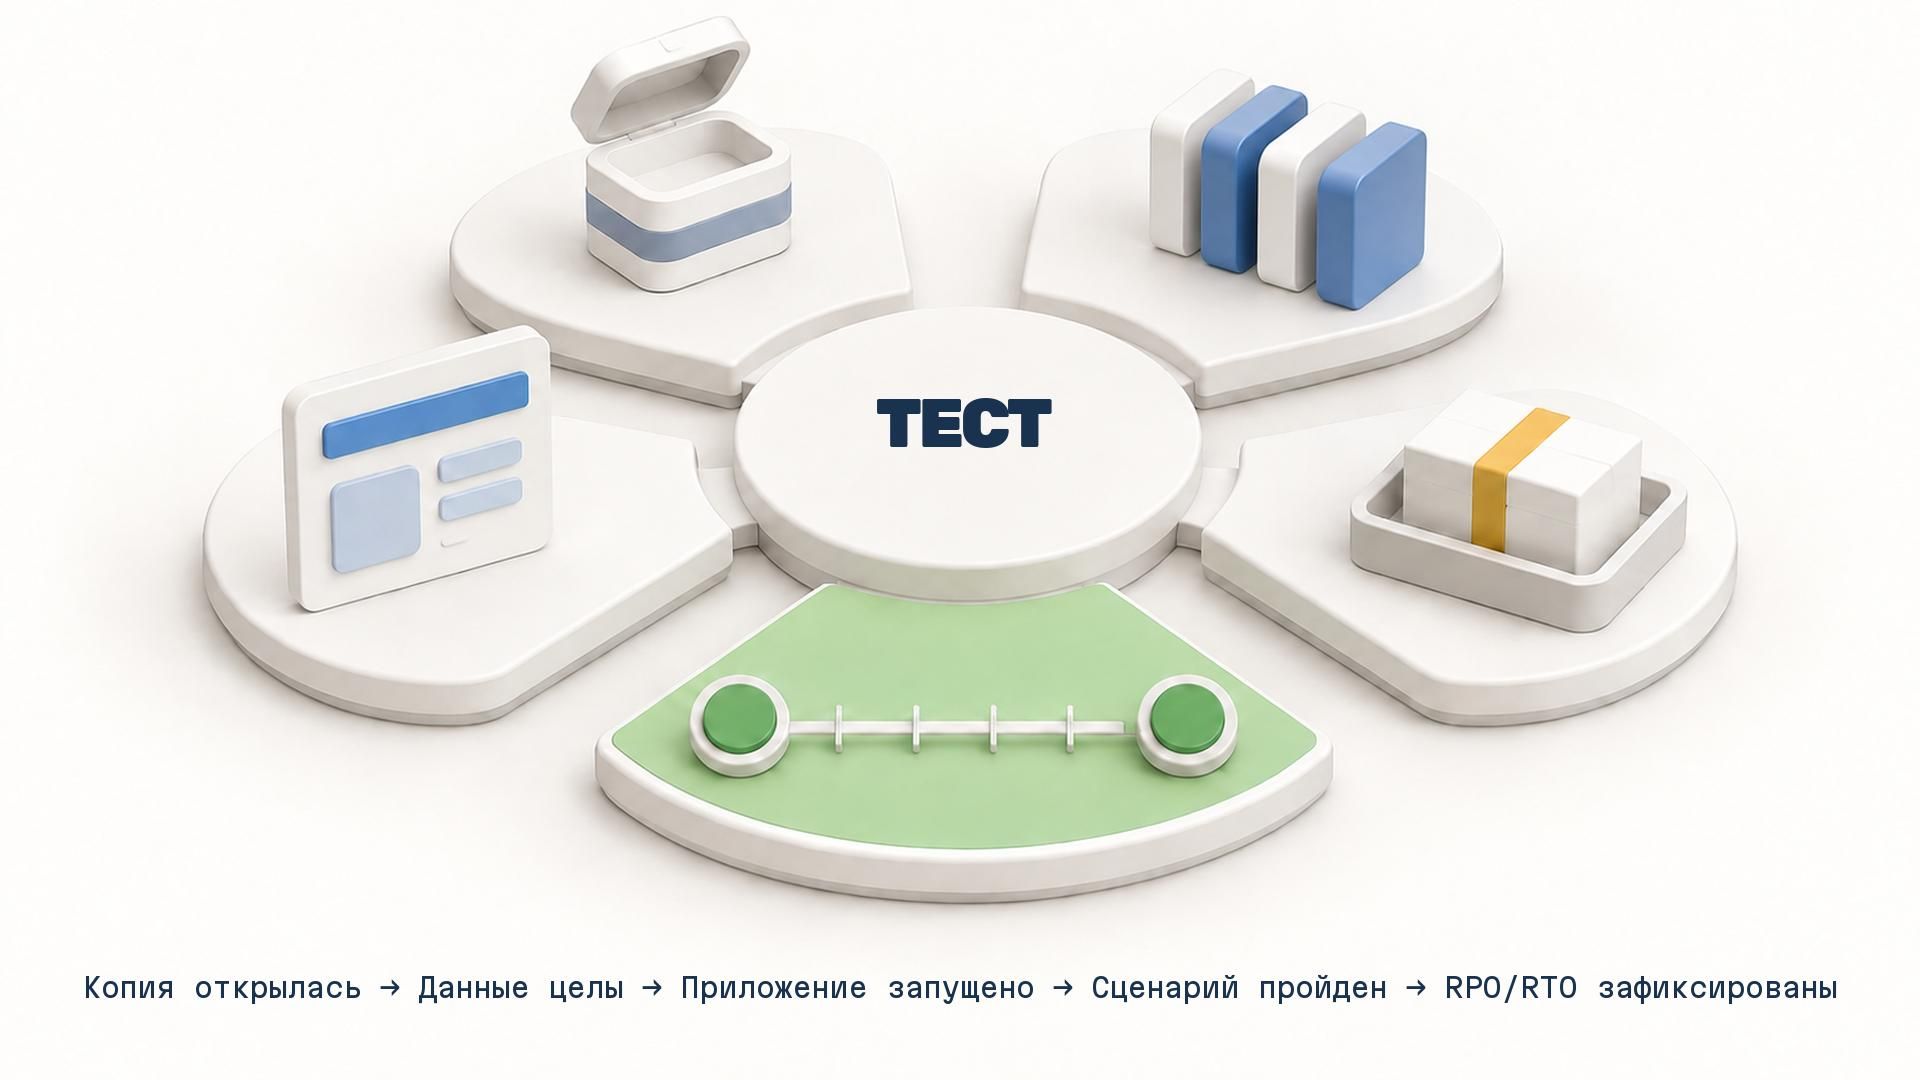
Тест бэкапа мы заканчиваем работающим сервисом в изолированном окружении. AWS называет типичной ошибкой восстановление ресурса без чтения и подтверждения целостности данных. Архив распаковался, база запустилась, а нужные таблицы повреждены или приложение не может подключиться.
Минимальное учение проводим по семи шагам:
- Выбираем конкретный сервис, его RPO и RTO.
- Берём точку восстановления по обычной производственной процедуре.
- Запускаем таймер и разворачиваем отдельное окружение.
- Проверяем целостность: контрольные суммы, количество записей и бизнес-инварианты.
- Подключаем приложение и проходим один критичный пользовательский сценарий.
- Фиксируем фактическую потерю данных и полное время до готовности.
- Обновляем инструкцию, автоматизацию и владельцев по итогам учения.
Бизнес-инвариант зависит от продукта. В «Стадикэтс» для проверки полезно сопоставить доступ к курсу, факт оплаты, отправленное задание и результат пробника. Для «Понимаю» — доступ пользователя и корректность данных о запланированной консультации.
Инструкцию отдаём сотруднику команды, который её не писал. Во время аварии автор может быть недоступен, а двусмысленный шаг увеличит паузу. В документе оставляем команды, критерии результата и условия остановки.
Копия в той же зоне риска исчезает вместе с оригиналом
Общий аккаунт администратора, один регион, доступное для записи сетевое хранилище или единая политика удаления связывают оригинал и копию общей причиной отказа. CISA советует хранить критичные резервные данные офлайн и в зашифрованном виде, регулярно проверять доступность и целостность копий.
В облачной инфраструктуре мы строим изоляцию из отдельного аккаунта, неизменяемого хранилища, раздельных ролей на создание и удаление копий, многофакторного подтверждения чувствительных операций и собственных оповещений. Конкретный набор зависит от угроз и стоимости простоя.
Репликация помогает быстро переключиться при отказе узла. Ошибочное удаление или повреждение может уйти и на реплику. Для возврата к состоянию до события используем независимую точку восстановления с подходящим сроком хранения.
Один журнал отвечает на вопрос «мы восстановимся?»
После каждого учения мы заполняем короткий паспорт результата: сервис и ответственного, точку и источник копии, целевые и фактические RPO/RTO, результат чтения данных, прохождение пользовательского сценария, найденные ограничения и дату следующего запуска.
AWS Prescriptive Guidance предлагает учитывать требования бизнеса и повторять тесты после существенных обновлений приложения или инфраструктуры. Поводом для внепланового прогона становятся рост объёма базы, смена версии СУБД, новый регион, ротация ключей, миграция хранилища и переработка критичного сценария.
Для большой образовательной или консультационной платформы этот журнал сохраняет связь между изменениями продукта и готовностью вернуться в работу. Новая интеграция, изменение авторизации или обновление сценария оплаты — повод проверить, что прежнее измерение RTO ещё относится к текущей архитектуре.
Пять вопросов перед следующим релизом
- Какие действия пользователей компания готова потерять и за какой интервал?
- Через сколько должен заработать каждый критичный сценарий?
- Где лежат копии и кто может их изменить или удалить?
- Когда сервис в последний раз поднимали с нуля из сохранённой точки?
- Какие RPO и RTO зафиксировали?
Мы считаем бэкап рабочим после тестового восстановления, проверки данных и фиксации фактических RPO и RTO. Без даты последнего учения и этих измерений заявленный срок остаётся ожиданием.
В Qtim бэкапы входят в инфраструктурный контур SaaS вместе с наблюдаемостью, SLA, дежурством и инструкциями для аварийных действий. Остальные составляющие собрали на странице о разработке SaaS-сервисов.
После остановленной команды мы уже знаем, из какой точки вернуть 300 ГБ и сколько займёт возврат системы в работу.