Масштабирование веб-приложения: 5 признаков архитектурного предела
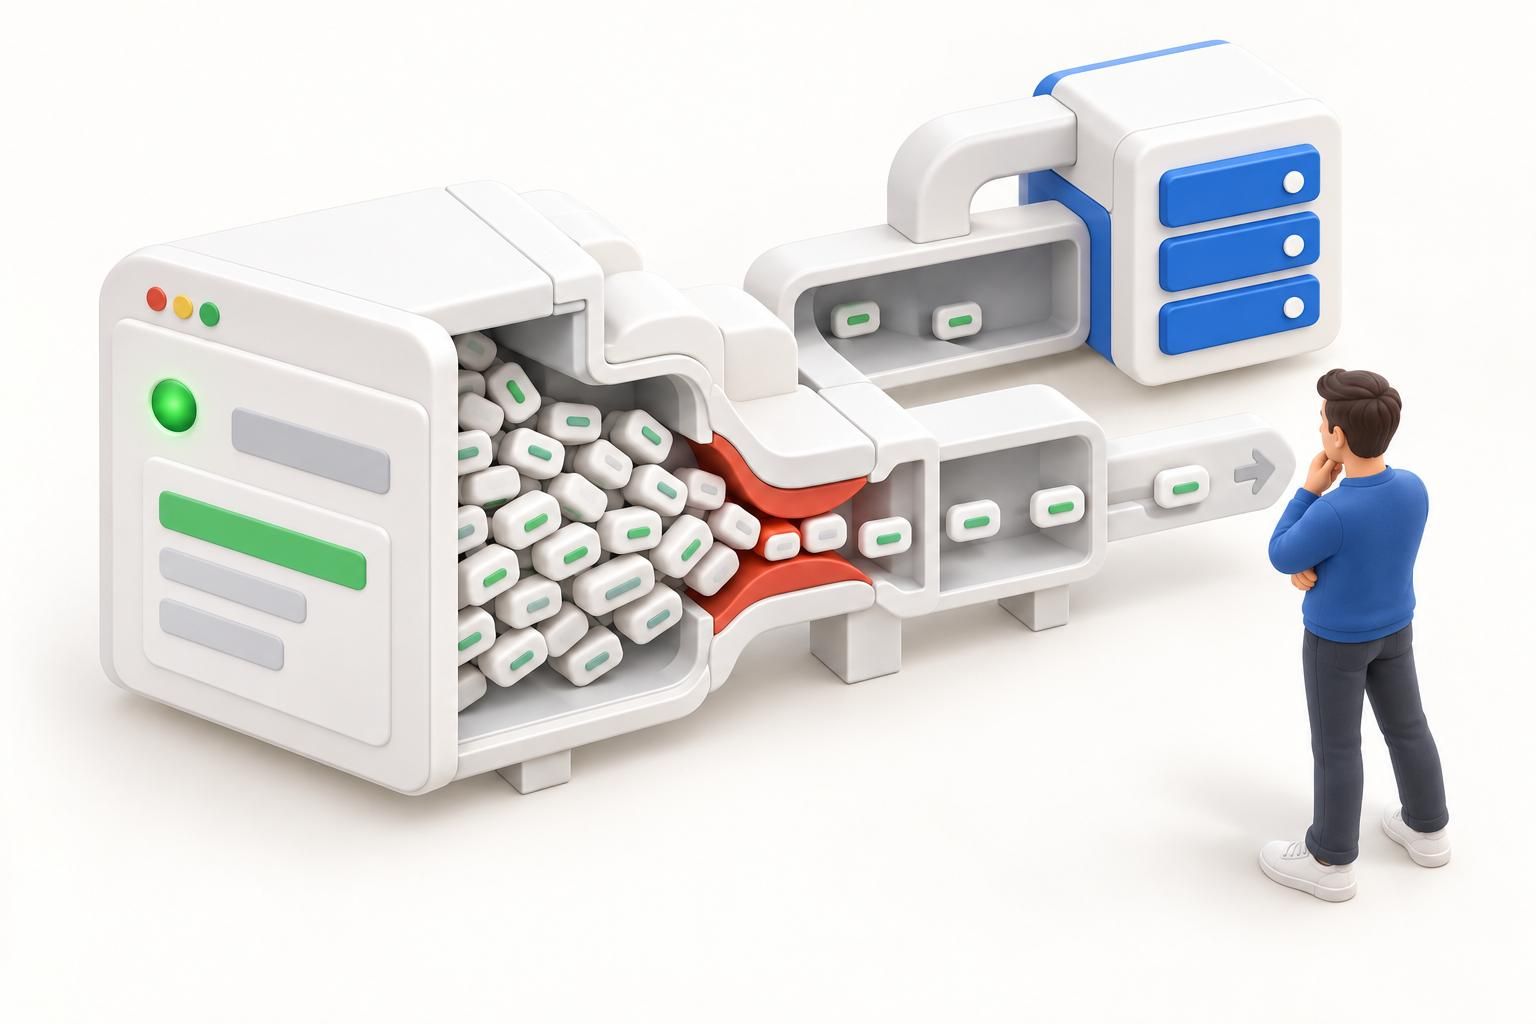
В разработанном нами интернет-магазине HOTZ Global покупатель оформляет заказ: собирает корзину, выбирает доставку и доходит до оплаты. Перед окончательным списанием сайт должен подтвердить резерв товара в 1С. Пока ответа нет, заказ нельзя безопасно провести дальше: один пользовательский шаг зависит от учётной системы и платёжного контура.
Такая цепочка может годами выглядеть исправной. Страницы открываются, заказы проходят, команда выпускает обновления. При этом продукту всё труднее переваривать новый объём, добавлять бренды и сохранять предсказуемое время ответа. В этот момент рост уже тормозит, хотя явной аварии по-прежнему нет.
В наших проектах мы разбираем подобные ситуации с позиции продуктовой команды: какой пользовательский путь теряет устойчивость, где появляется ограничитель и какой эксперимент подтвердит гипотезу. Ниже перечислены пять сигналов, которые помогают начать такую диагностику без гадания по среднему времени ответа и загрузке процессора.
Среднее время ответа спокойно, а p99 уже портит сценарий
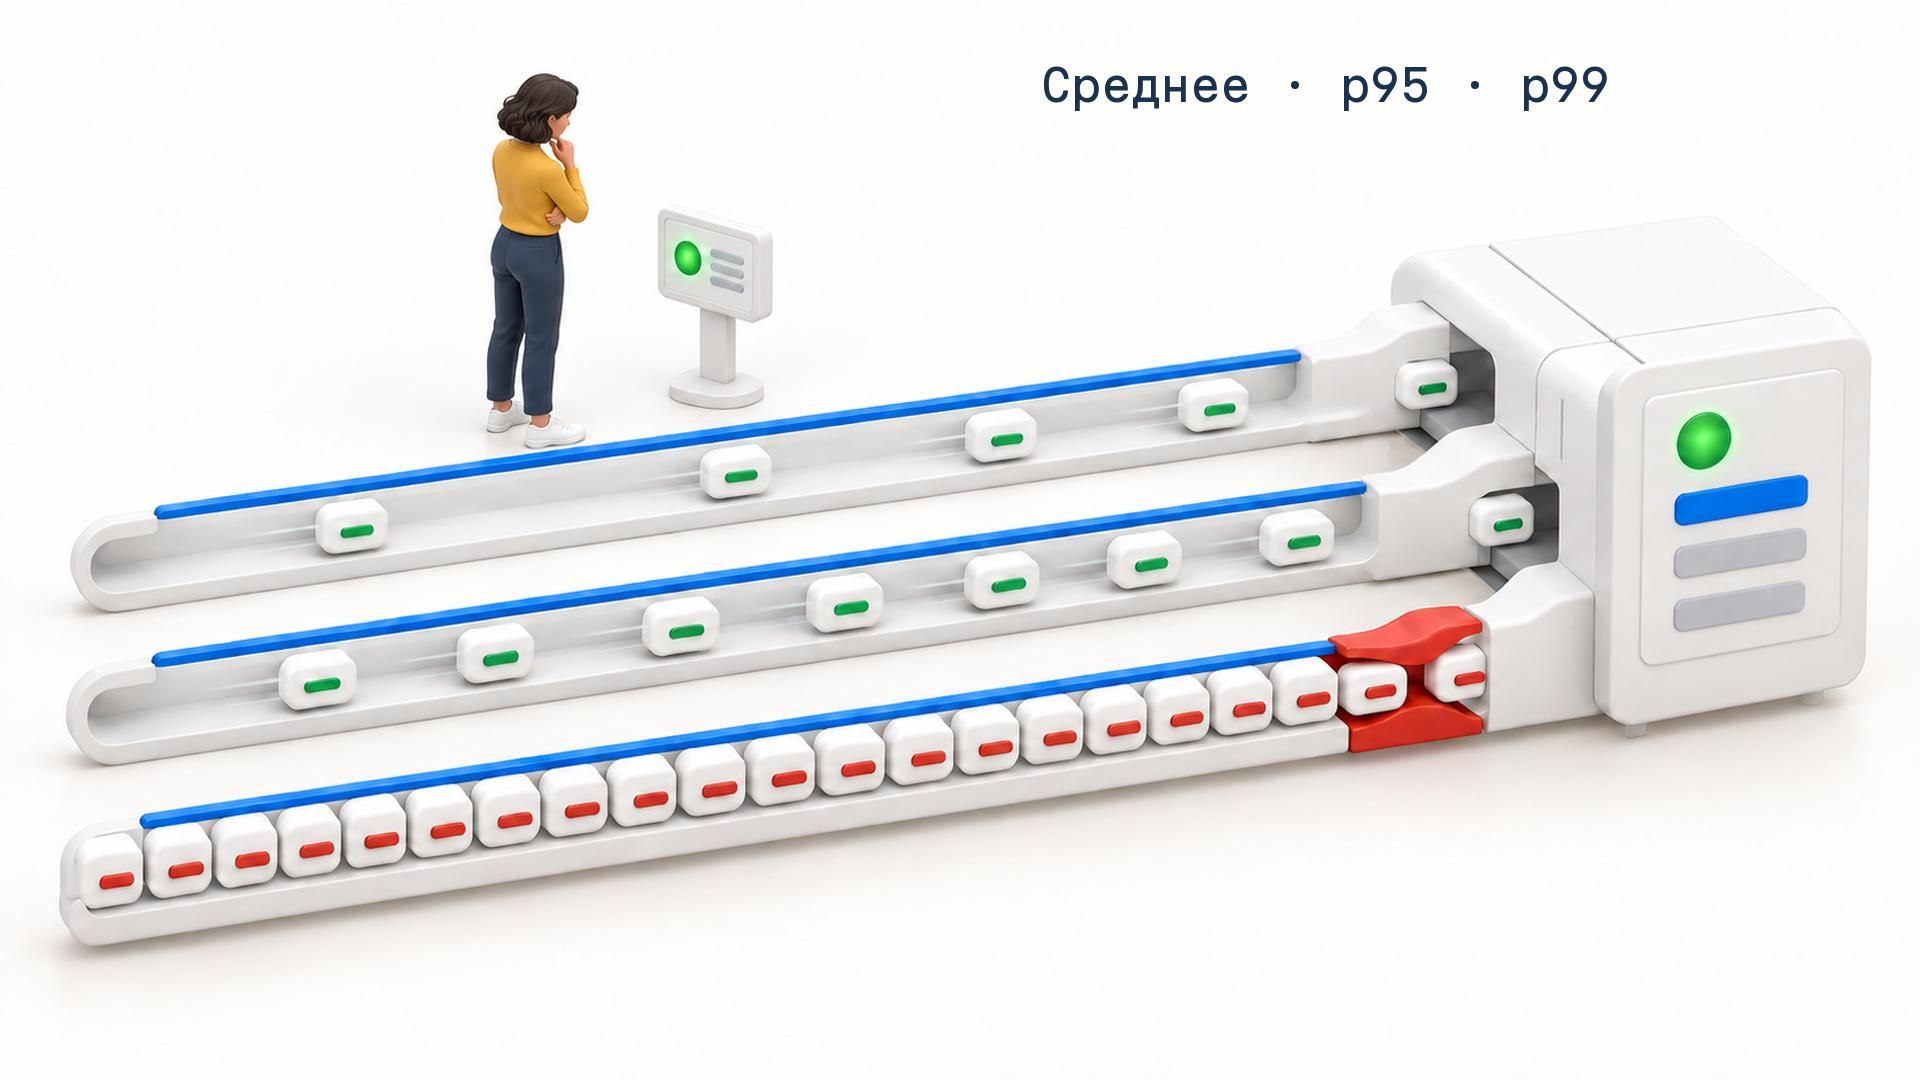
Среднее значение удобно для отчёта, но оно сглаживает редкие задержки. Перцентиль p99 показывает границу, в которую укладывается 99% измерений; оставшийся процент запросов выполняется дольше. Эту медленную часть распределения называют tail latency, или хвостом задержки. Для пользователя именно она может стать обычным опытом: один экран собирает данные из нескольких запросов, и вероятность встретить медленный ответ растёт.
В руководстве Google SRE по мониторингу советуют смотреть на четыре «золотых сигнала»: задержку, трафик, ошибки и насыщение ресурсов. Рост p99 иногда предупреждает о приближении к насыщению раньше, чем среднее значение. Google также рекомендует разделять задержку успешных и ошибочных запросов. Быстрый ответ с ошибкой улучшит общую среднюю, хотя сценарий для пользователя уже оборвался.
У p99 нет универсальной красной линии. Нужный предел задаёт сам сценарий: ожидания покупателя, зависимые операции и допустимое время для бизнеса. Сам перцентиль показывает симптом, причины в нём нет. База данных, блокировка, сборка мусора, внешний API или один тяжёлый тип запроса могут выглядеть на графике похоже.
Начните со ступенчатого нагрузочного теста одного пути: увеличивайте поток запросов этапами и рядом снимайте p95, p99, ошибки, объём трафика и занятость ограниченных ресурсов. p95 устроен так же, как p99, только охватывает 95% измерений. Сравнение кривых покажет момент, когда хвост начинает расходиться со средним. После этого профилирование кода и запросов к базе уже отвечает на конкретный вопрос, а не ищет проблему по всему приложению.
Очередь не закончилась вместе с пиком
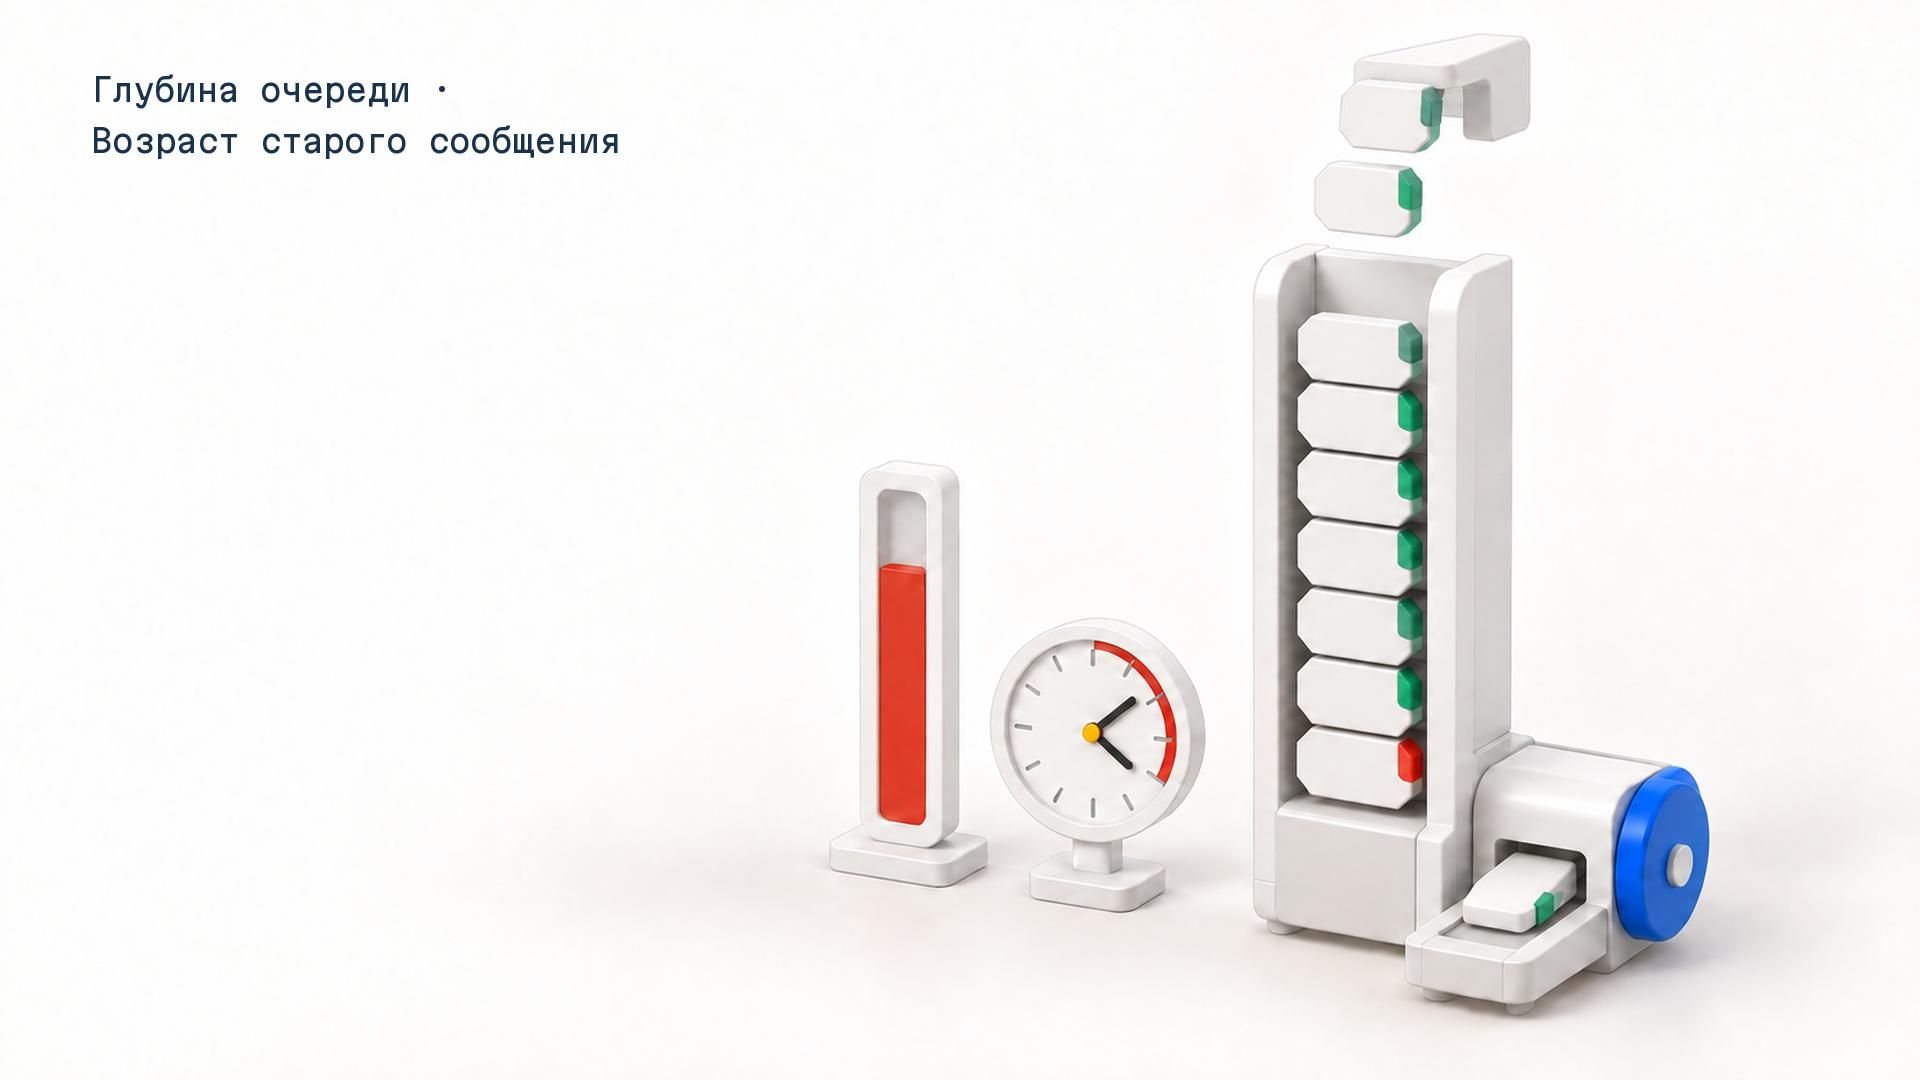
Очередь отделяет приём задачи от её выполнения. Это полезно для импорта, синхронизации, генерации файлов и других операций, которые покупателю не нужно ждать в открытом запросе. Но длина очереди сама по себе мало что говорит. Десять тысяч коротких задач могут исчезнуть быстрее, чем сотня тяжёлых.
В рекомендациях AWS Well-Architected глубина рабочей очереди названа одним из возможных сигналов для масштабирования. AWS предлагает выбирать метрику под нагрузочным тестом с фиксированным числом ресурсов: спрос растёт, а затем падает, и хороший индикатор должен двигаться вместе с ним. Руководство Microsoft Azure добавляет более полезную для бизнеса величину: критическое время, то есть интервал от отправки сообщения до завершения обработки. Длинная очередь допустима, пока каждое сообщение обрабатывается в принятый для процесса срок.
Настораживает другая картина: после сопоставимого пика глубина не возвращается к исходному уровню, возраст старейшего сообщения увеличивается, а скорость обработки уступает скорости поступления. Это уже похоже на рассогласование нагрузки и доступной мощности. Сравнивать нужно одинаковые окна и типы задач. Иначе очередь после ночного импорта и очередь заказов дадут красивый, но бесполезный график.
В проекте HOTZ Global мы применили BullMQ, систему очередей для Node.js: синхронизация с 1С, импорт каталога, обработка изображений и пересборка товарного фида выполняются вне пользовательских запросов. Этот кейс показывает архитектурный приём. Он не доказывает, что у проекта накапливался хвост задач. Диагностировать очередь надо по её собственным метрикам и допустимому времени бизнес-процесса.
Новый сервер добавили, пропускная способность почти не выросла
Горизонтальное масштабирование добавляет экземпляры приложения. Пропускная способность показывает, сколько успешных операций система завершает за единицу времени. В идеальной схеме рост числа экземпляров заметно поднимает общий результат. Реальная кривая постепенно выравнивается, и её форма важнее обещания «добавим ещё сервер».
Azure прямо предупреждает: новые экземпляры не гарантируют ускорения. Сервису нужна горизонтально масштабируемая архитектура. Stateless-компонент, то есть компонент без критичного состояния в памяти конкретного экземпляра, позволяет обработать следующий запрос на любом узле. Affinity, то есть привязка пользователя или серии запросов к одному узлу, сужает этот выбор. Нужен и запас мощности, или headroom: свободная ёмкость на время, пока автомасштабирование замечает нагрузку и запускает ресурсы.
Проверка довольно приземлённая. Зафиксируйте профиль запросов и прогоните одну ступенчатую нагрузку при разном количестве экземпляров. Смотрите на общую пропускную способность и результат каждого узла, соединения с базой, ожидание блокировок, чтение и запись. AWS рекомендует именно фиксировать ресурсы во время теста и постепенно повышать спрос, чтобы выбрать рабочую метрику масштабирования.
Слабый прирост означает, что следует искать общую границу. Ею может оказаться база, пул соединений, блокировка, локальное состояние или внешний сервис, но название причины появится только после измерений. Покупка вычислительных ресурсов до этого теста иногда увеличивает счёт и оставляет производительность на прежней полке.
Один внешний сервис определяет скорость всего заказа
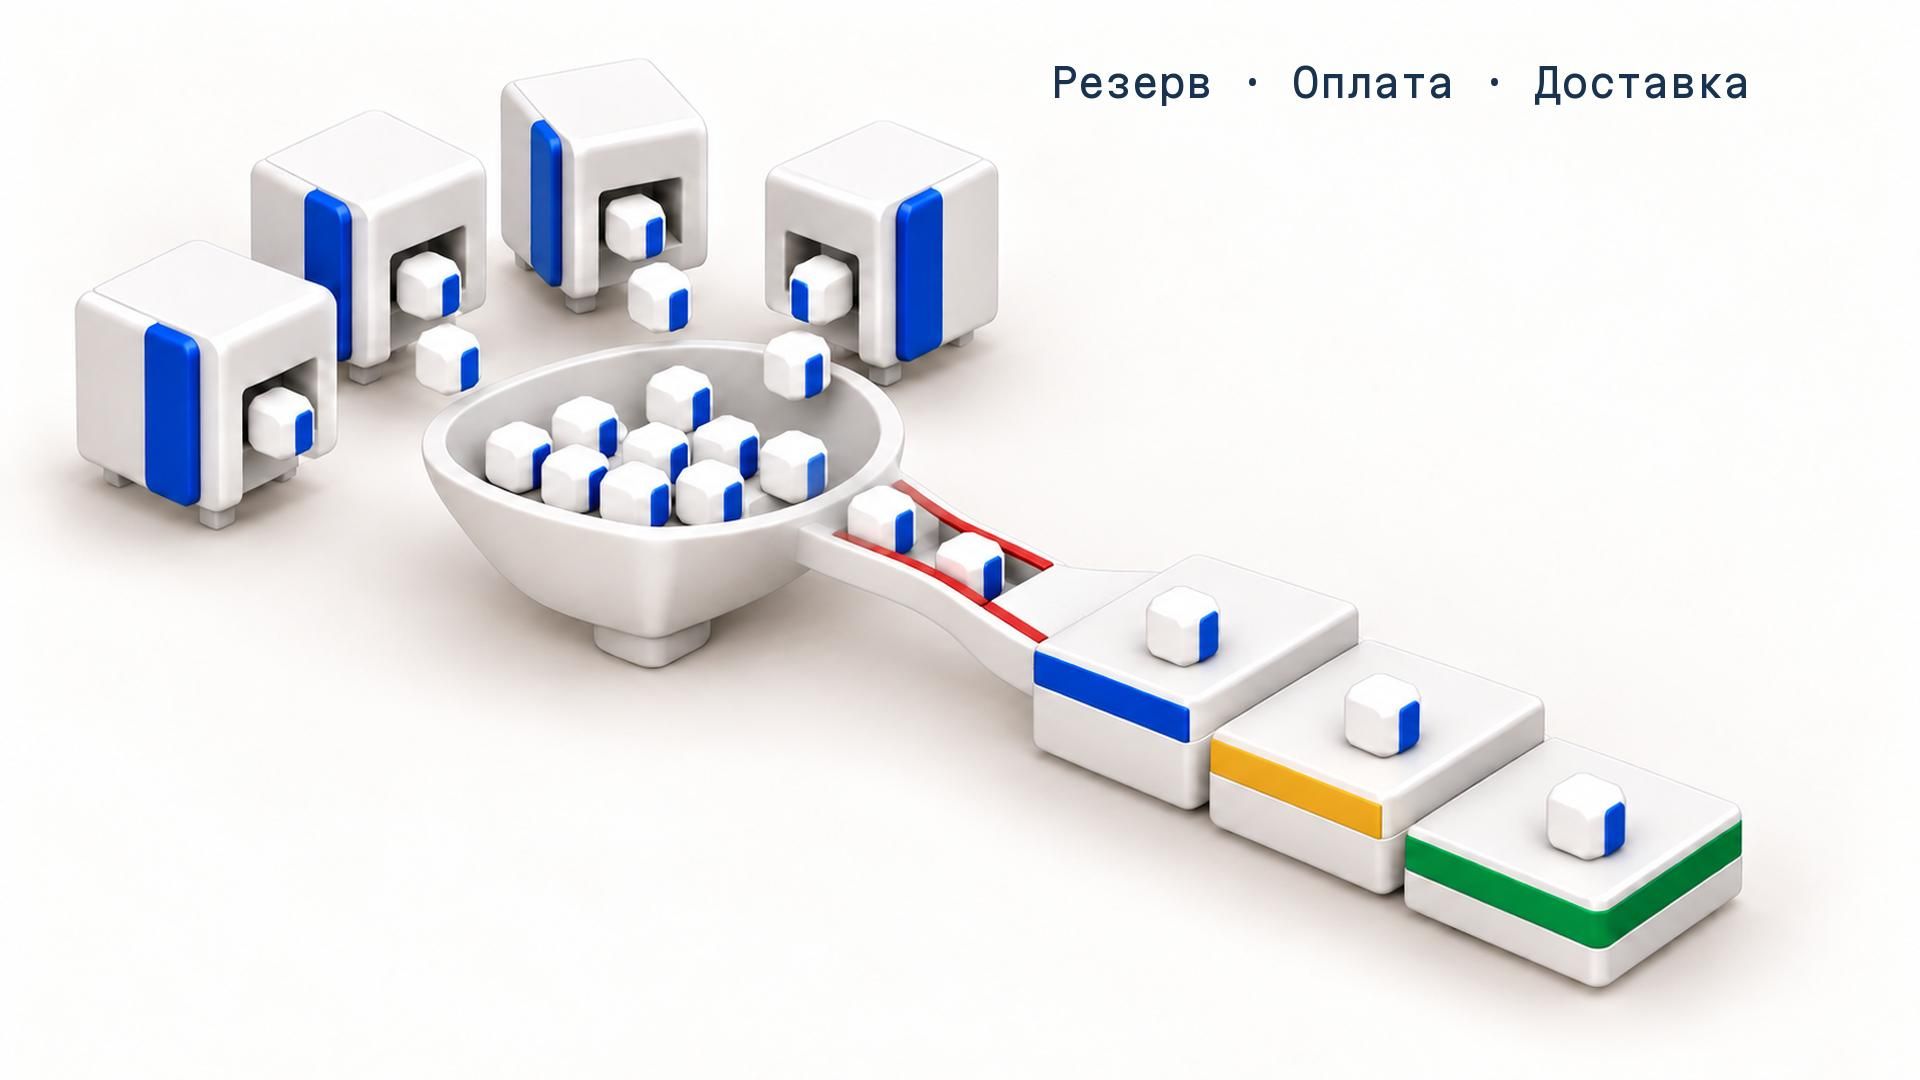
Внешняя зависимость входит в критический путь, когда следующий шаг ждёт её ответа. Для диагностики полезно измерять задержку каждого такого вызова, тайм-ауты, повторные попытки и незавершённые операции. Тайм-аут ограничивает ожидание ответа. Повторная попытка, или retry, запускает операцию ещё раз после временной ошибки. Общая длительность пользовательского пути без этих разрезов скрывает, внутри приложения ушло время или на его границе.
В интернет-магазине HOTZ Global заказ проходит через СДЭК, 1С и ЮKassa. Сайт рассчитывает доставку, запрашивает резерв в 1С, после подтверждения авторизует платёж в ЮKassa, закрывает резерв продажей и завершает списание. При исчерпании попыток система отменяет платёж, а состояния резерва и оплаты остаются в журнале событий. Подробно эта последовательность разобрана в кейсе интернет-магазина HOTZ Global.
Ограничение выявляет трассировка: она раскладывает одну операцию на участки и показывает время каждого вызова.
Проведите в тестовой среде контролируемую задержку и отказ зависимости. Проверьте, что пользовательский запрос завершается предсказуемо, повтор не создаёт второй заказ или платёж, а незаконченная операция видна команде. Идемпотентность здесь означает безопасное повторение запроса без нового бизнес-эффекта. Журнал событий сохраняет последовательность шагов. Circuit breaker, или автоматический предохранитель, временно прекращает бесполезные обращения к нестабильной зависимости. Очередь переносит продолжение операции из пользовательского запроса в фоновую обработку.
Независимые релизы размножают общее исправление на четыре контура
Пятый сигнал заметен не на графике серверов, а в истории изменений. Одна продуктовая правка затрагивает несколько модулей или репозиториев, проходит несколько циклов проверки и ждёт несколько выпусков. Система выдерживает текущий трафик, однако скорость развития падает.
В B2B-каталогах «Тепломаша», Sonniger, Volcano и WDB мы использовали переиспользованную архитектуру для четырёх независимых контуров. У каждого бренда свои фронтенд, бэкенд, база, административная часть и выпуск; код размещён в восьми репозиториях. Такая граница даёт независимые релизы и изолирует сбои одного бренда от остальных. Цена проявляется в общем изменении: одинаковое исправление приходится переносить по четырём контурам и отдельно проверять каждый.
Здесь нет автоматического вердикта в пользу объединения. Независимость оправдана, когда бренды выпускаются в разном ритме, по-разному развивают интерфейс или должны переживать сбои раздельно. Связанное развитие превращает ту же схему в множитель lead time, времени от решения о правке до её выхода.
Возьмите одно недавнее сквозное изменение и проследите весь путь: сколько модулей и репозиториев пришлось открыть, сколько выпусков дождаться, где повторилась одна проверка. Кейс B2B-каталога «Тепломаш» полезен именно как пример компромисса: быстрое тиражирование архитектуры купило независимость контуров, а общие изменения получили четыре адреса.
Переписывать систему пора после теста на ограничитель
Полную переработку архитектуры по одному тревожному графику мы не согласовываем. Это дорогой способ проверить гипотезу. Сначала соберите пять сигналов в одной картине и проведите короткие эксперименты. У каждого результата должен быть следующий кандидат на проверку, а не готовый диагноз.
Для очереди ограничьте приём новых задач, когда обработчики не успевают. Это обратное давление. Затем задайте число параллельных обработчиков и пропускайте срочные операции раньше фоновых с помощью приоритетов. Для пользовательского запроса профилирование покажет, где код тратит время; после этого проверьте запросы к базе, кэш и лимиты соединений. Каждая мера отвечает на своё ограничение, поэтому выбирайте её по результатам эксперимента.
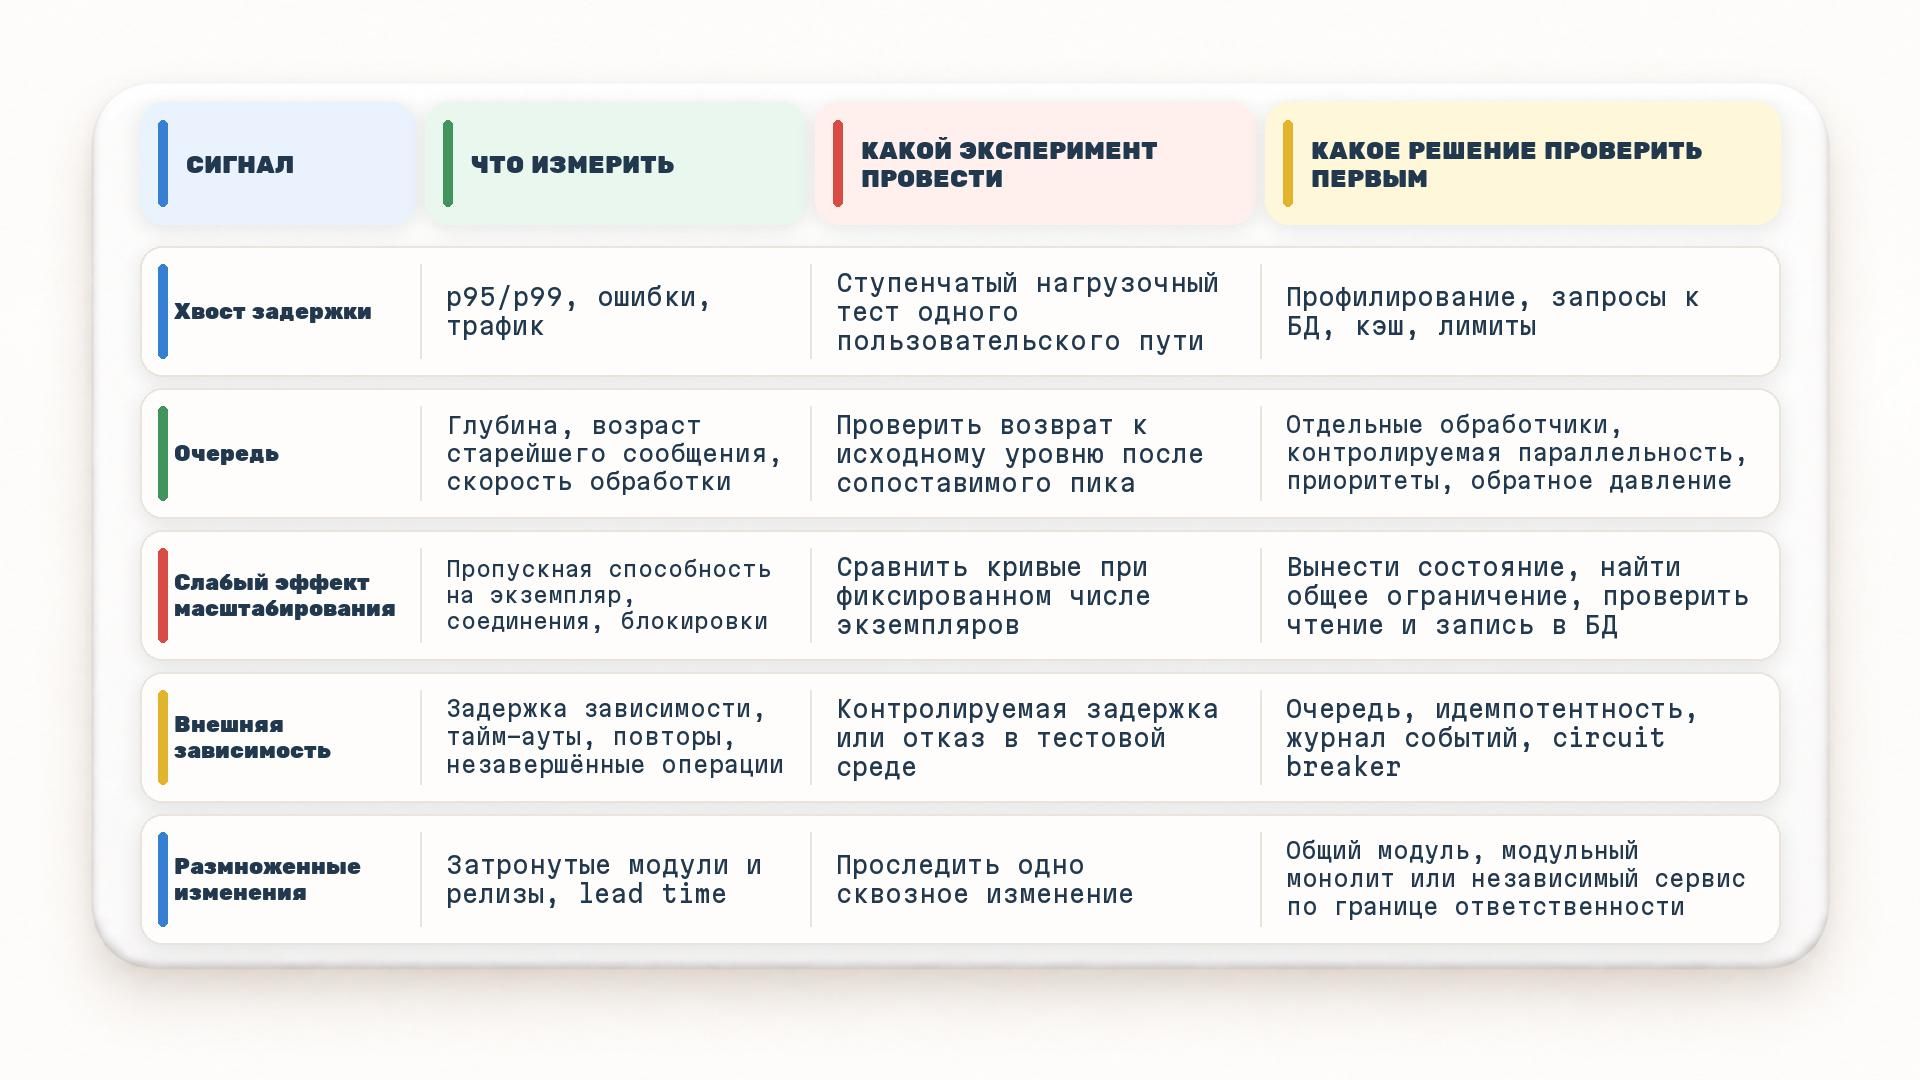
Такой разбор не назначает архитектуру заочно. Он заставляет связать симптом, измерение и проверяемое действие. После эксперимента решение может оказаться локальным: индекс в базе, отдельные обработчики очереди, ограничение параллелизма или изоляция одной интеграции. Переписывание оправдано, когда измеренный ограничитель лежит в самой границе компонентов и локальная правка сохраняет прежний потолок.
Вернёмся к заказу HOTZ Global. Покупатель видит один путь до оплаты, а система координирует доставку, резерв и платёж. Такой маршрут полезно тестировать целиком и по участкам: где растёт хвост задержки, как завершаются фоновые задачи, что происходит при контролируемом отказе внешней системы.
Сначала найдите ресурс или связь, которые ограничивают рост. Затем меняйте границы системы.
Как подготовить продукт к масштабированию ещё на этапе пилота
Многие из пяти сигналов закладываются задолго до роста трафика. На демо руководитель проводит тестовый заказ, оплата проходит, пилот принят. Через неделю менеджер просит добавить корпоративного клиента, ограничить ему права и подтянуть данные из 1С — и первая реальная правка затрагивает половину системы. Второй сценарий, новая роль или интеграция ломают решения, принятые специально для демонстрации.
Пилот с планом на рост — не уменьшенная копия будущего продукта, а проверка узкой гипотезы с сохранённой возможностью развивать систему. До запуска фиксируют то, что дорого переделывать, а функции и мощности наращивают после подтверждения спроса. Пять решений дешевле принять до первого пользователя:
- Сущности и статусы. Пользователь, организация, заказ, тариф, урок и платёж должны иметь понятные связи. Если заказ привязан прямо к одному человеку, корпоративный кабинет потребует переделать права, отчёты и историю операций. Интерфейс меняется за один цикл разработки, ошибка в модели данных расходится по всей системе.
- Границы модулей. Каталог, оплата, доступы, уведомления и отчёты меняются с разной скоростью. Для раздельного развития микросервисы не обязательны: достаточно структуры, в которой платёжное правило не спрятано в кнопке, а проверка доступа не размазана по десятку экранов.
- Единый API к бизнес-правилам. Веб-интерфейс, мобильное приложение и партнёрский кабинет обращаются к одному ядру, поэтому новый канал подключается без переноса логики. Если гипотезу можно проверить в браузере, мобильное приложение добавляют позже — когда сценарий зависит от функций устройства или частых возвращений.
- Модель прав отдельно от названий ролей. В пилоте хватает администратора и пользователя, но завтра менеджеру понадобится доступ только к своим клиентам, а бухгалтеру — только к платежам. В проектах на NestJS мы разделяем две проверки: guard решает, можно ли войти в сценарий, а политика доступа — можно ли выполнить действие над конкретным объектом.
- События основного пути и технические сигналы. Счётчик регистраций мало говорит о ценности. Нужны события сценария — нашёл товар, оплатил, вернулся — и рядом ошибки, время ответа и сбои интеграций.
Схема данных, короткая документация, тестовая среда и понятная выкладка выглядят скучно, но именно они позволяют другой команде продолжить продукт, если пилот держался на памяти одного разработчика.
Когда выделять отдельный сервис, а когда хватит модульной структуры
Микросервисы раньше нагрузки масштабируют в основном смету. Отдельные сервисы, Kubernetes, несколько мобильных приложений и расчёт нагрузки на аудиторию, которой пока нет, удорожают пилот и отодвигают ответ на гипотезу. Первой версии чаще хватает модульной структуры, согласованной схемы данных, API для основного сценария, базовых прав и мониторинга: журналов событий, метрик и оповещений.
Контур разделяют, когда появляется проверяемая причина: часть продукта нужно выпускать независимо, нагрузка на один участок мешает остальным или командам нужны отдельные зоны ответственности. Несколько примеров из наших проектов:
- Онлайн-школа №1. Роли, авторизация, расписание и записи занятий остались на NestJS, а медиаконтур видеосвязи (WebRTC и SFU) вынесли на Go, когда граница задачи стала понятна. Цена решения — отдельная среда исполнения, сборка, выкладка, мониторинг и распределённая отладка; её платят ради изоляции конкретного узкого места.
- «Стадикэтс». Ученики массово сдают задания перед дедлайном, а обработка файлов требует времени. Такие задачи вынесли в фоновую очередь на BullMQ и Redis: кабинет принимает работу, отдельный обработчик разбирает файл и обновляет результат, а очередь сглаживает пик.
- HOTZ. Платформу для четырёх продуктовых линеек с разными аудиториями запустили за три месяца на одном коммерческом ядре — каталог, корзина, заказ, доставка и обмен с 1С. Разные визуальные коды направлений легли поверх общей модели товаров и заказов. Это обратная сторона компромисса из примера с четырьмя контурами выше: общее ядро избавляет от размножения общих правок.
План роста после пилота: четыре слоя
Сигналом к масштабированию служит наблюдаемое изменение в работе продукта, а не круглая цифра в презентации. Обычно всё начинается с мелочей: сотрудник раз в неделю переносит данные между CRM и админкой, менеджеру временно выдают общий аккаунт, администратор просит разработчика поменять статус прямо в базе, тяжёлая операция задерживает основной путь.
После пилота обещанную метрику сопоставляют с поведением пользователей и раскладывают план по четырём слоям:
| Слой | Какой вопрос задают |
|---|---|
| Продуктовый | Какой сценарий подтвердился и что мешает повторному использованию |
| Данные | Хватает ли текущих сущностей, статусов и истории |
| Технический | Какой участок уже создаёт задержки или ошибки |
| Операционный | Может ли команда выпускать изменения, видеть сбои и передавать ответственность |
Дальше работают по узким местам: автоматизируют повторяющуюся передачу данных, уточняют права, отправляют тяжёлую обработку в фон. Отдельный сервис появляется, когда профиль нагрузки действительно отличается от остальной системы. Правило можно записать в одну строку: в пилот закладывают дорогие в переделке решения, а мощности и функции добавляют после подтверждения спроса.
Вопросы и ответы
Нужны ли микросервисы, чтобы веб-приложение масштабировалось?
Нет, на старте чаще хватает модульной структуры, единой схемы данных и API к бизнес-правилам. Отдельный сервис выделяют, когда участок нужно выпускать независимо или его нагрузка мешает остальной системе — и это подтверждено измерениями.
Что заложить в пилот, чтобы потом не переписывать продукт?
Модель данных и статусов, границы модулей, единый API, модель прав отдельно от ролей и аналитику основного пути. Эти решения дорого менять после запуска, а функции и мощности можно добавить по мере спроса.
Как понять, что продукту пора масштабироваться?
По наблюдаемым признакам: растёт хвост задержки, очередь не возвращается к исходному уровню после пика, новые серверы почти не добавляют пропускной способности, появляются ручные переносы данных и обходные решения с правами. Каждый признак проверяют отдельным экспериментом.
Разберите с нами узкие места, измеримые эксперименты и план изменений в рамках поддержки и развития цифрового продукта.