Миграция в облако: план переноса, проверка отката и риски простоя
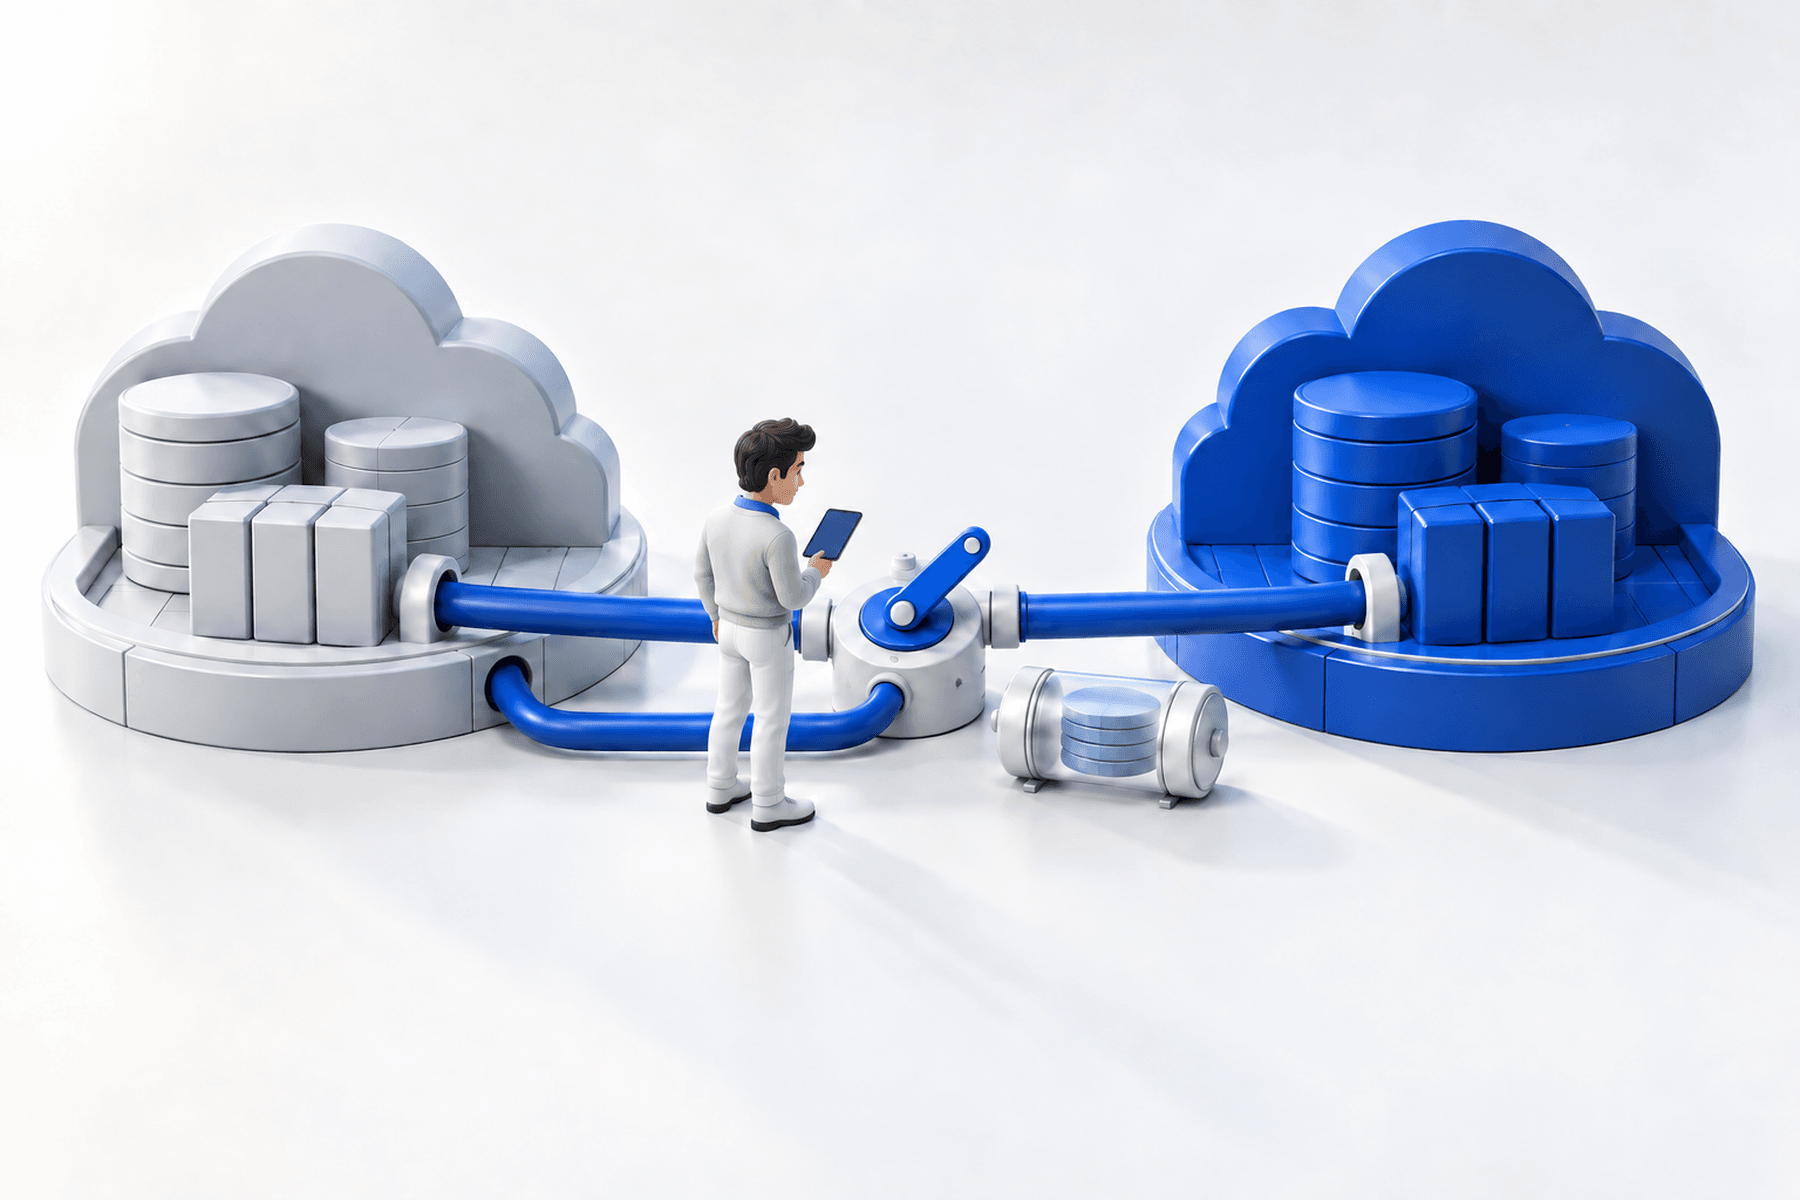
В день переключения у команды открыты два контура, график репликации и общий чат. Новая среда готова принимать трафик, старая ещё обслуживает пользователей, а любое неверное решение меняет данные сразу в нескольких местах.
Миграция в облако требует большего, чем перенос серверов. Нужно заранее определить состав работ, зависимости, способ синхронизации, допустимое окно простоя и условия возврата. Ниже — план, который помогает провести переезд как управляемое изменение продукта.
Сначала решают, какую часть системы переносить
Облако не исправляет архитектуру автоматически. Если приложение зависит от локального файлового хранилища, общего сетевого диска или жёстко заданных адресов, эти связи сохранятся после переезда или проявятся в момент запуска.
Поэтому миграция начинается с инвентаризации. В неё входят приложения, базы, очереди, файлы, задания по расписанию, сертификаты, DNS, внешние API, каналы связи, учётные записи и процессы поддержки. Для каждого компонента фиксируют владельца, критичность и зависимости.
После инвентаризации выбирают стратегию для каждого блока. Rehost переносит нагрузку с минимальными изменениями. Replatform заменяет часть инфраструктуры управляемыми сервисами. Refactor меняет код и архитектуру. Одному продукту часто нужен смешанный план: статичные файлы переезжают отдельно, база получает новый контур репликации, а приложение на первом этапе запускается без глубокой переработки.
Решение записывают через проверяемый результат. Например: «приложение работает в новой среде с прежним поведением», «база восстанавливается из резервной копии», «фоновые задачи запускаются один раз». Название облачного сервиса само по себе результатом не считается.
Карта зависимостей определяет порядок волн
Компоненты переносят группами, которые способны работать вместе. Если приложение обращается к базе, хранилищу и корпоративной системе авторизации, разрыв одной связи остановит весь сценарий. Простая сортировка по владельцам серверов здесь не поможет.
Карту удобно строить от пользовательских и операционных действий: вход, создание заказа, загрузка документа, расчёт, отчёт, обмен с партнёром. Для каждого действия отмечают сервисы, данные и сетевые маршруты. Так становятся видны скрытые зависимости, которые отсутствуют в каталоге инфраструктуры.
Первая волна должна дать команде опыт без критического риска. Подходящий кандидат имеет ограниченное число связей, понятный объём данных и владельца, готового провести приёмку. Самую важную систему не используют как учебный пример для нового процесса.
После каждой волны обновляют runbook — пошаговый сценарий перехода, время операций и список обнаруженных зависимостей. План следующего этапа строится на факте, а не на первоначальной оценке.
Репетиция cutover проходит до рабочего окна
Cutover — момент, когда пользователи или системы начинают обращаться к новому контуру. AWS включает в этот этап заморозку записи, финальный бэкап, синхронизацию данных, переключение маршрутизации и проверку результата. Последовательность разобрана в AWS Prescriptive Guidance.
Каждый шаг нужно выполнить на тестовой миграции. Команда измеряет длительность копирования и восстановления, проверяет скрипты, права, сетевые правила и наблюдаемость. Репетиция выявляет операции, которые существуют только в голове конкретного инженера.
Тестовый контур должен быть достаточно похож на рабочий по версии программ, схеме данных и ключевым интеграциям. Уменьшенный объём допустим, если команда отдельно проверила, как длительность масштабируется на полный набор данных. Иначе успешная репетиция закончится раньше, чем реальный бэкап успеет скопироваться.
Перед переключением назначают владельца каждого шага и канал фиксации результата. Фраза «посмотрим по графикам» не определяет, кто принимает решение и какой показатель считается нормальным.
План перехода должен помещаться в один runbook
| Этап | Действие | Контроль | Решение |
|---|---|---|---|
| Подготовка | Проверить доступы, резервные копии, репликацию и готовность поддержки | Все обязательные проверки закрыты ответственными | Начать окно или перенести |
| Заморозка | Остановить или ограничить операции, которые меняют данные | В старом контуре нет новых неподтверждённых записей | Продолжить синхронизацию |
| Финальная синхронизация | Перенести изменения после последней копии | Отставание реплики и контрольные суммы в допуске | Переключить трафик или остановиться |
| Переключение | Изменить маршрутизацию и включить новый контур | Критические сценарии проходят, ошибки и задержки в пределах порогов | Продолжить наблюдение или откатить |
| Стабилизация | Усилить мониторинг и поддержку | Система выдерживает рабочую нагрузку, данные сверены | Закрыть миграцию или оставить ограничения |
Пороги в этой таблице компания задаёт заранее. Для одного продукта допустима короткая остановка записи. Для другого даже несколько минут без оформления заказа нарушают обязательства перед клиентами. Универсальная цифра здесь создаёт ложную уверенность.
Откат проектируют вместе с прямым переходом
Рабочий rollback начинается с триггеров. Команда заранее определяет, при каких ошибках, задержках или расхождениях прекращает исправлять новую среду и возвращает трафик. У каждого триггера есть источник данных и человек, который принимает решение.
AWS отдельно выделяет три части плана: контрольные точки, работу с данными и владельца выбора между исправлением в новом контуре (fix forward) и откатом. Последний пункт часто недооценивают. Во время сбоя несколько специалистов могут одинаково разумно предлагать противоположные действия.
Главная сложность появляется после первой записи в новом контуре. Старая база уже отстаёт, поэтому обратное переключение трафика способно вернуть пользователей к неполному состоянию. План должен объяснять, как новые транзакции попадут обратно: через обратную репликацию, журнал изменений, восстановление или отдельную процедуру обработки.
Rollback проверяют на репетиции. Команда возвращает маршрутизацию, восстанавливает данные и повторно проходит критические сценарии. Непроверенная инструкция описывает намерение, а не реальную способность вернуться.
Параллельный контур уменьшает простой и повышает цену координации
Для критичных систем часто поднимают новую среду рядом со старой. Microsoft рекомендует параллельное развёртывание для сложных миграций и нагрузок с жёсткими требованиями к доступности. Преимущество понятно: трафик можно переводить постепенно, а исходный контур остаётся доступным для возврата.
Обратная сторона — две среды, синхронизация и риск расхождения. Нужно решить, где разрешена запись, как долго поддерживается параллельная работа и кто следит за отставанием. Двойная запись из приложения добавляет собственные сценарии частичного отказа: одна система подтвердила операцию, другая нет.
Постепенное переключение работает, когда трафик делится по пользователям, регионам, клиентам или тенантам. Сначала новый контур получает ограниченную группу, затем доля растёт после проверки. Такой подход не подходит автоматически для тесно связанных данных, где разные пользователи меняют общие сущности.
Выбор между окном простоя и параллельным контуром удобно делать по четырём критериям: допустимая недоступность, сложность синхронизации, объём изменяемых данных и стоимость поддержки двух сред. Чем строже требование к простою, тем больше проектной работы переходит в репликацию и контроль.
После переключения проверяют бизнес-сценарии и данные
Зелёный статус серверов ещё не означает завершённую миграцию. Приёмка должна пройти по тем же действиям, из которых строилась карта зависимостей: вход, заказ, платёж, документ, интеграция, отчёт. Сотрудники бизнеса подтверждают результат вместе с технической командой.
Наблюдаемость готовят до cutover. Нужны метрики доступности и задержек, журналы, трассировка критических запросов и алерты на отставание репликации. После перехода команда должна видеть, где возникла ошибка: на входе, в приложении, базе или внешней связи.
Отдельно выполняют сверку данных. Сравнивают количество и состояние ключевых сущностей, контрольные суммы или другие подходящие признаки. Итог «строки скопировались» слабее проверки, что оплаченный заказ сохранил состав, статус и связь с платежом.
Старый контур выключают после периода стабилизации и подтверждённой сверки. Раннее удаление экономит инфраструктуру, но закрывает быстрый путь к восстановлению. Дату отключения привязывают к критериям готовности, а не только к календарю проекта.
Свежий отчёт не заменяет собственную карту рисков
В отчёте Parallels 2025 собраны ответы более 600 IT-специалистов и руководителей из США, Великобритании, Канады, Японии и ЕС. Респонденты отдельно отмечали риски безопасности при переходе в облако. Это полезный контекст, но он не определяет вероятность проблемы в конкретной системе.
Собственная карта рисков должна связать угрозу с компонентом, сценарием и контролем. Например, изменение сетевых правил проверяется через доступность конкретного API; ошибка ролей — через тестовые учётные записи; потеря данных — через восстановление и сверку. Общая строка «проверить безопасность» не даёт критерия приёмки.
Миграция завершена, когда старый контур перестал быть страховкой
После стабилизации команда обновляет документацию, владельцев, процедуры дежурства, резервное копирование и план восстановления уже для новой среды. Временные доступы отзывают, миграционные каналы закрывают, ресурсы старого контура выводят из эксплуатации по согласованному графику.
Короткое правило: перенос можно запускать, когда команда умеет пройти прямой путь, распознать неуспех и вернуть систему вместе с изменившимися данными.
Если вы планируете переезд действующего продукта, мы можем разобрать архитектуру и подготовить план миграции с волнами, критериями cutover, проверкой отката и порядком стабилизации.